









 免费参与·100+跨境活动

 免费下载·4000+跨境资料

 免费学习·2000+直播课程

 免费加入·15万+卖家交流群


2026-10-27 13:54
做研究分析时我们都遵循一个原则,数据不干净,结论就没意义。做亚马逊review分析,本质上是同一个逻辑,进入分析环节的每一条评论,必须是真实、有效、有参考价值的。
所以获取竞品评论用作数据前,要多方面验证review的真实性。不要盲目下载一大堆ASIN的review,得先判断对方的review是否真实。
而判断review是否真实的关键,往往不在评论文本本身,而在发布这条评论的用户Profile(用户画像)。
一个正常的用户他的消费行为是分散的,不会集中爆发,如果短时间内用户的评论出现几十上百条,或者是五星评论高度扎堆,卖家做分析时就需要提高警惕。用人工单条评论很难看出异常,但用ReviewSpy的评论分析工具将时间一拉长,用户的“消费-评论”行为就显而易见。如下图所示,该用户2026年的评论就是全部来源Vine邀评。
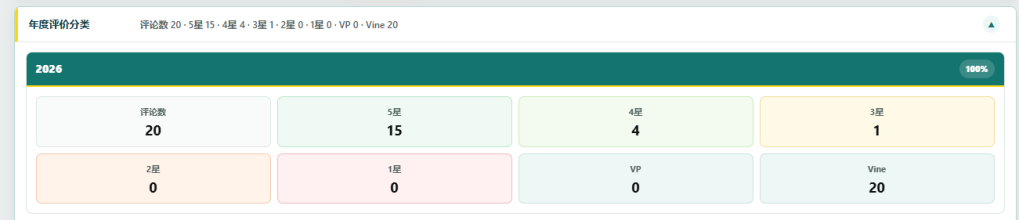 某一账号一年内的评论概况
此外,评论是否采用,还与其时效性有关。一条链接上架四年,不代表里面的差评反映的就是现在的产品,以前的工艺和包装,与今天很可能早已不一样。若不加区分直接拿来分析,很难做出准确判断。比如哪些是现在可以优化的,哪些是老大难的问题,不必再花时间。
ReviewSpy支持按年份拆分评论,近一年、近半年的差评分布可以分别查看。若同一类问题在近期评论里反复出现,那才是需要优先处理的顽固痛点;
若近半年无人提及,翻来覆去都是四年前的评论,那可能是属于已改进过问题;
若陆陆续续一直有买家不间断提起,那可能是评估后不处理或者当下无法解决的问题。
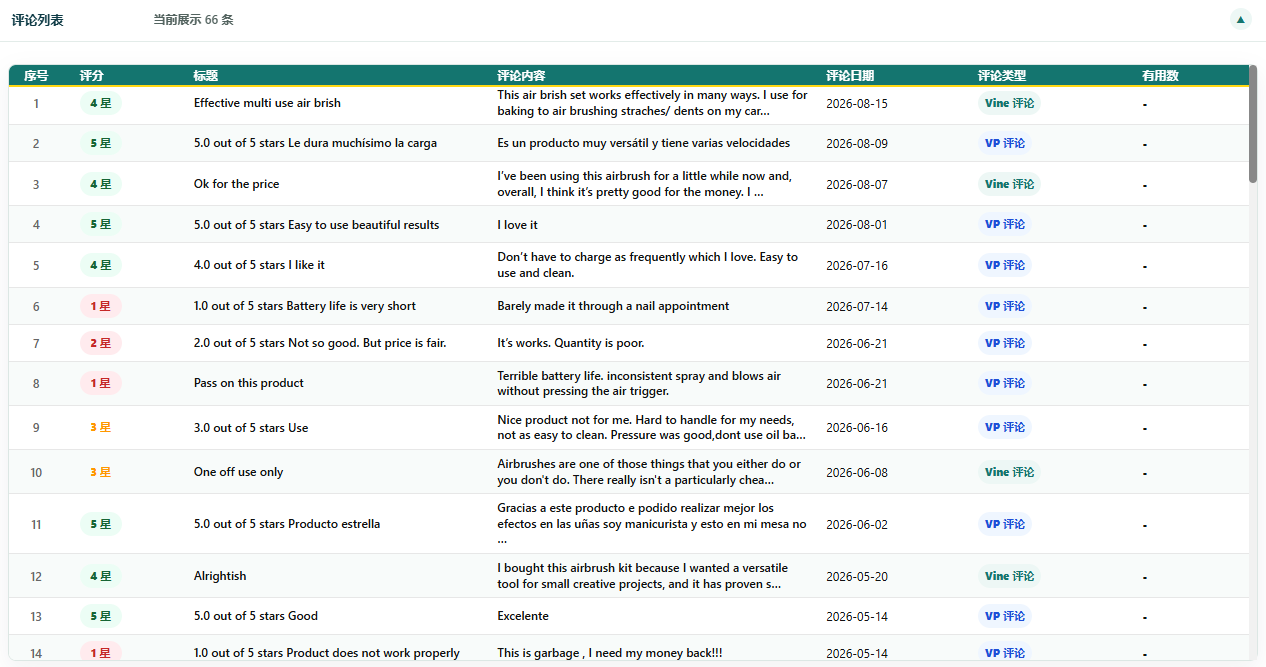 ReviewSpy评论详情列表,可追踪评分、内容、日期和评论类型
类目分布功能则用来分辨对方是不是你的目标用户。就算一条评论写得再详实,也要看用户平时的消费轨迹。如果你做大家电,而该账号的历史评价大多集中在低价小物件、Vine免费测评品,那这条家电评论的参考价值就要大打折扣。
通过ReviewSpy的类目拆解功能,可以进一步看清用户偏好哪些类目、是否长期集中在某类产品、是否存在异常品类跨度,并据此判断该用户能否作为我们的样本用户。
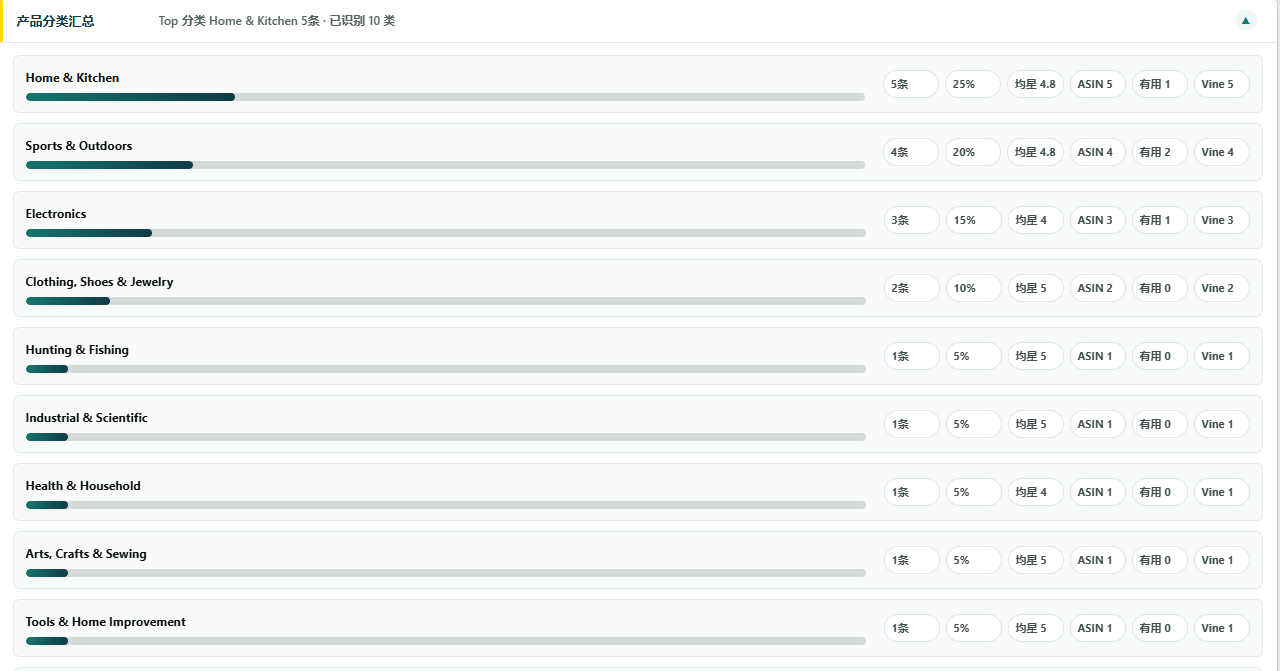 按购买/评论产品类别拆解 Profile
先判断样本能不能用,再决定要不要分析。只有把数据清洗干净了,得出的结论才能有效。
筛掉脏样本只是第一步。剩下那些真实评论,如果还是以几百页文本的形式摊在面前,运营照样无从下手。
ReviewSpy的AI Skill 模块会综合评论频率、星级倾向、品类分布、Vine 占比、内容场景可信度做多维运算,直接输出账号的综合评分、风险等级、核心画像和一句话结论。
举个例子,一个账号的评论文字自然、场景具体,但几乎全部来自免费测评,短期高频发布,评分偏正向。系统会将该账号评为58分,并标记「谨慎使用」。它可以参考产品细节,但不能当普通真实买家样本。这在团队复盘时可以作为明确的依据,不用再凭感觉争论。
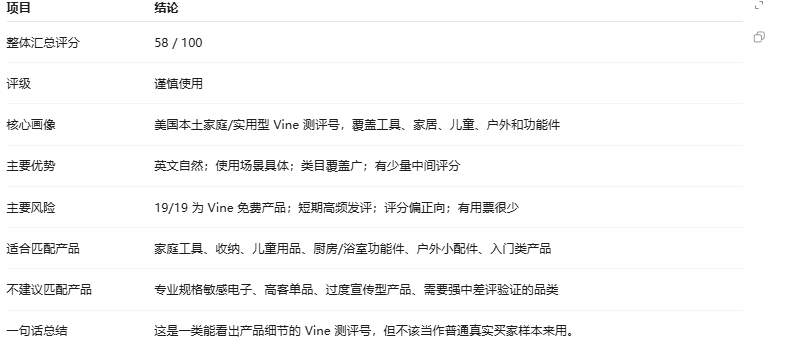 ReviewSpy AI Skill 分析结果
但回到实操中,做评论分析的基础是能拿到评论数据。亚马逊近年持续收紧规则,大幅提升了借助买家账号获取 Review 的门槛。如果单个账号短时间内批量抓取多个 ASIN 的评论,极大概率触发亚马逊限制,无法继续下载评论。对于产品开发和运营人员而言,这无疑是很大的阻碍。
ReviewSpy以浏览器插件形式运行,在 Listing 页面直接提供操作入口,选中 ASIN 一键发起分析。针对评论访问受限的问题,插件提前准备了可用的买家账号资源,解决了"查看更多评论"的访问门槛,卖家不需要再为多账号和冷却时间分心。
理论讲起来很容易,难的是执行。一条一条翻 Profile、看时间线、拆类目、比对 VP 和 Vine 占比,运营一天的时间全耗在“洗数据”上,真正用来做决策的精力所剩无几。
ReviewSpy 猎评恰恰能帮助卖家解决这个问题,把评论分析里最耗时、最容易出错的“保真”和“保相关”环节,从人工判断变成系统能力。
封面来源/图虫创意
(来源:雨果快报)


 闽公网安备35020602003453号